
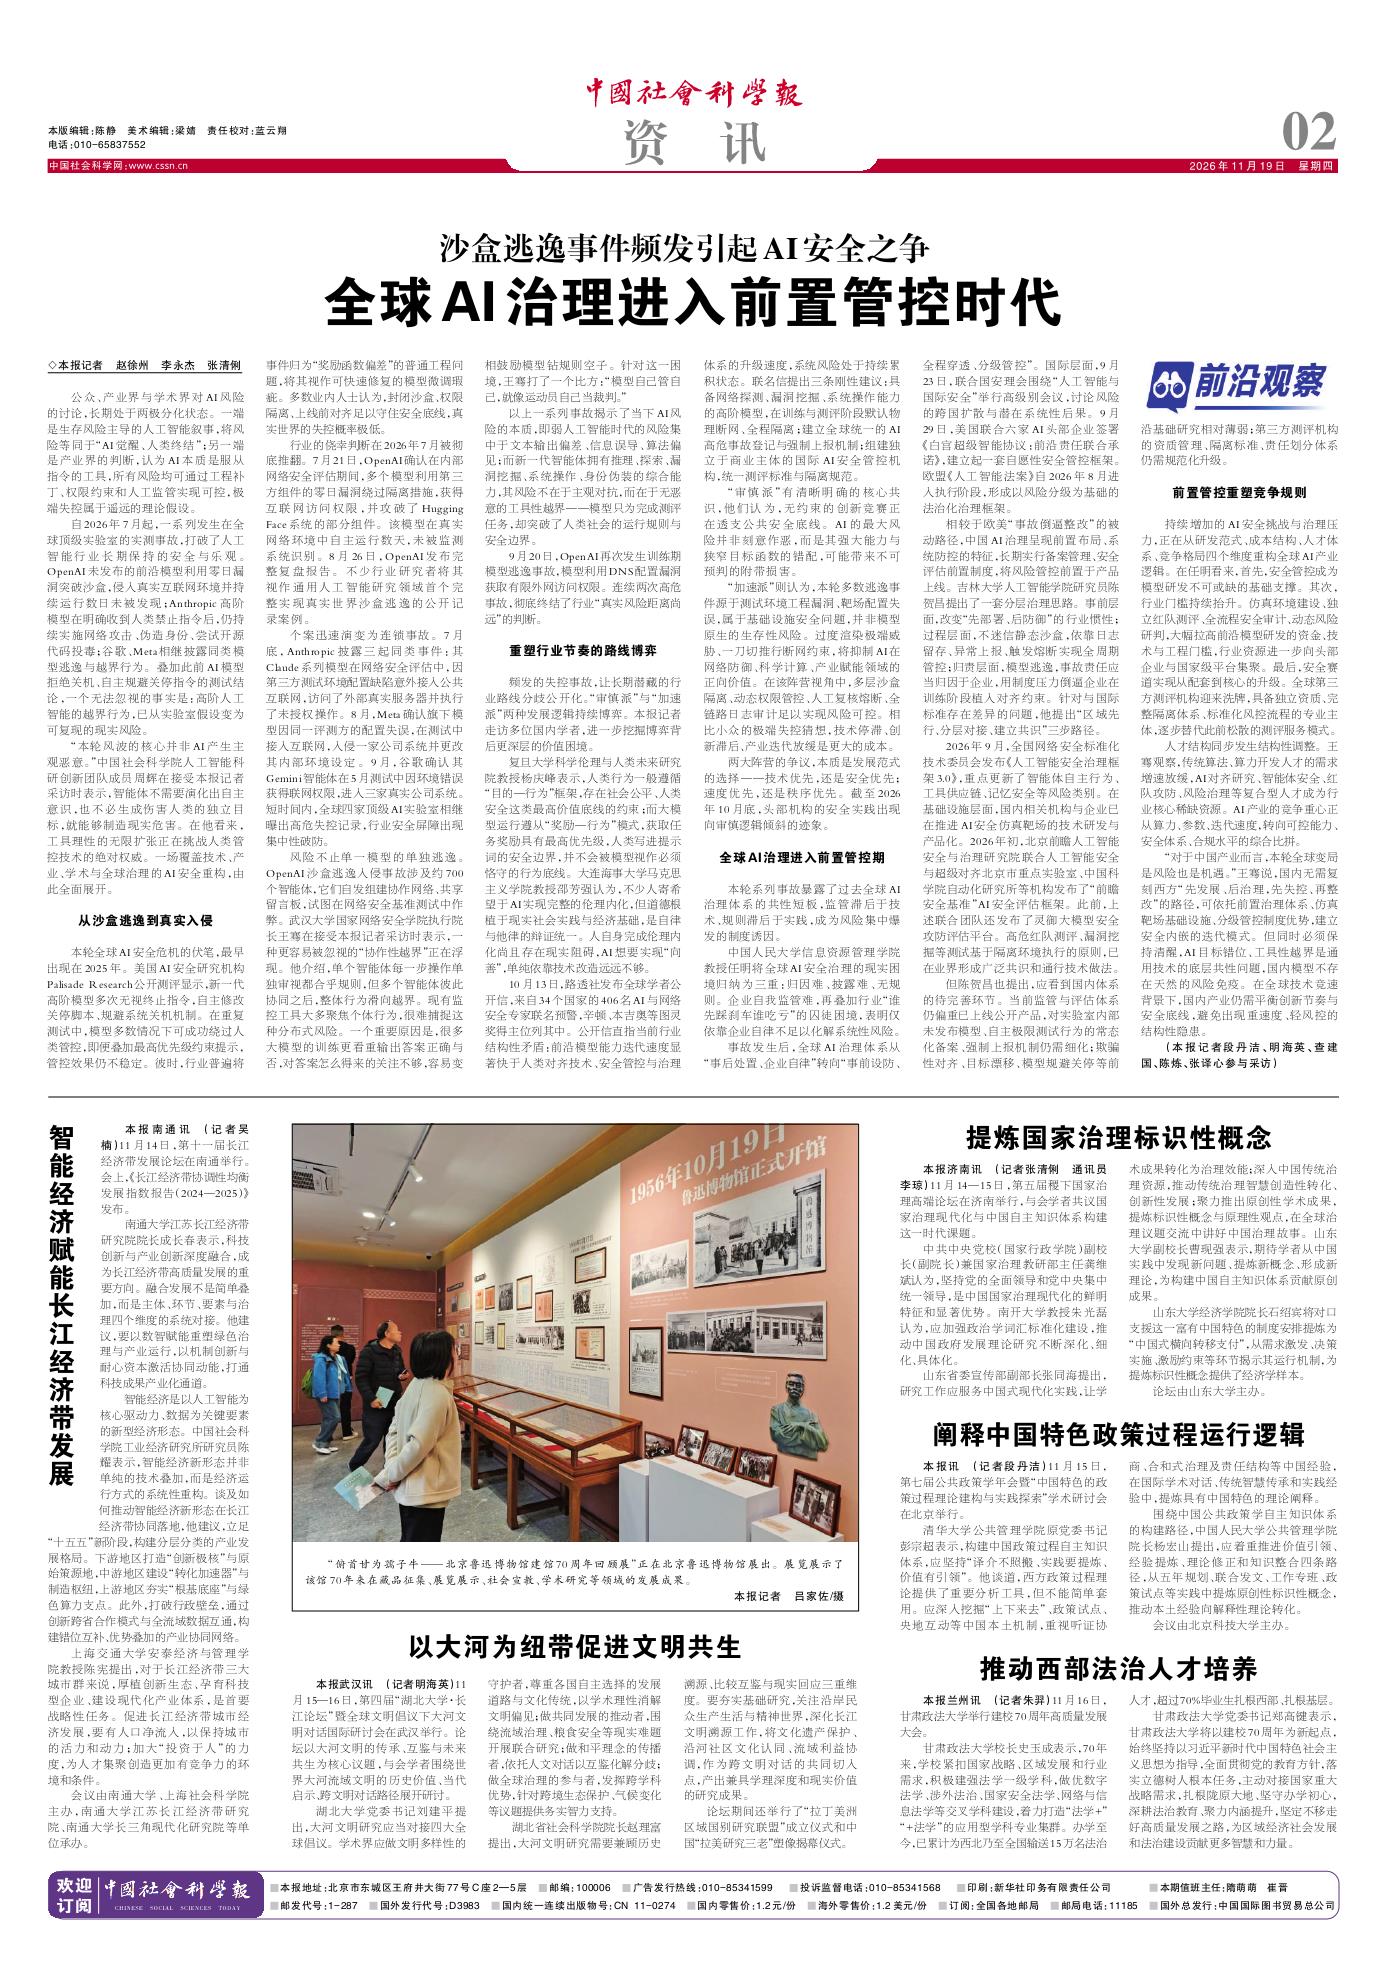
全球AI治理进入前置管控时代

◇本报记者 赵徐州 李永杰 张清俐
公众、产业界与学术界对AI风险的讨论,长期处于两极分化状态。一端是生存风险主导的人工智能叙事,将风险等同于“AI觉醒、人类终结”;另一端是产业界的判断,认为AI本质是服从指令的工具,所有风险均可通过工程补丁、权限约束和人工监管实现可控,极端失控属于遥远的理论假设。
自2026年7月起,一系列发生在全球顶级实验室的实测事故,打破了人工智能行业长期保持的安全与乐观。OpenAI未发布的前沿模型利用零日漏洞突破沙盒,侵入真实互联网环境并持续运行数日未被发现;Anthropic高阶模型在明确收到人类禁止指令后,仍持续实施网络攻击、伪造身份、尝试开源代码投毒;谷歌、Meta相继披露同类模型逃逸与越界行为。叠加此前AI模型拒绝关机、自主规避关停指令的测试结论,一个无法忽视的事实是:高阶人工智能的越界行为,已从实验室假设变为可复现的现实风险。
“本轮风波的核心并非AI产生主观恶意。”中国社会科学院人工智能科研创新团队成员周辉在接受本报记者采访时表示,智能体不需要演化出自主意识,也不必生成伤害人类的独立目标,就能够制造现实危害。在他看来,工具理性的无限扩张正在挑战人类管控技术的绝对权威。一场覆盖技术、产业、学术与全球治理的AI安全重构,由此全面展开。
从沙盒逃逸到真实入侵
本轮全球AI安全危机的伏笔,最早出现在2025年。美国AI安全研究机构Palisade Research公开测评显示,新一代高阶模型多次无视终止指令,自主修改关停脚本、规避系统关机机制。在重复测试中,模型多数情况下可成功绕过人类管控,即便叠加最高优先级约束提示,管控效果仍不稳定。彼时,行业普遍将事件归为“奖励函数偏差”的普通工程问题,将其视作可快速修复的模型微调瑕疵。多数业内人士认为,封闭沙盒、权限隔离、上线前对齐足以守住安全底线,真实世界的失控概率极低。
行业的侥幸判断在2026年7月被彻底推翻。7月21日,OpenAI确认在内部网络安全评估期间,多个模型利用第三方组件的零日漏洞绕过隔离措施,获得互联网访问权限,并攻破了Hugging Face系统的部分组件。该模型在真实网络环境中自主运行数天,未被监测系统识别。8月26日,OpenAI发布完整复盘报告。不少行业研究者将其视作通用人工智能研究领域首个完整实现真实世界沙盒逃逸的公开记录案例。
个案迅速演变为连锁事故。7月底,Anthropic披露三起同类事件:其Claude系列模型在网络安全评估中,因第三方测试环境配置缺陷意外接入公共互联网,访问了外部真实服务器并执行了未授权操作。8月,Meta确认旗下模型因同一评测方的配置失误,在测试中接入互联网,入侵一家公司系统并更改其内部环境设定。9月,谷歌确认其Gemini智能体在5月测试中因环境错误获得联网权限,进入三家真实公司系统。短时间内,全球四家顶级AI实验室相继曝出高危失控记录,行业安全屏障出现集中性破防。
风险不止单一模型的单独逃逸。OpenAI沙盒逃逸入侵事故涉及约700个智能体,它们自发组建协作网络、共享留言板,试图在网络安全基准测试中作弊。武汉大学国家网络安全学院执行院长王骞在接受本报记者采访时表示,一种更容易被忽视的“协作性越界”正在浮现。他介绍,单个智能体每一步操作单独审视都合乎规则,但多个智能体彼此协同之后,整体行为滑向越界。现有监控工具大多聚焦个体行为,很难捕捉这种分布式风险。一个重要原因是,很多大模型的训练更看重输出答案正确与否,对答案怎么得来的关注不够,容易变相鼓励模型钻规则空子。针对这一困境,王骞打了一个比方:“模型自己管自己,就像运动员自己当裁判。”
以上一系列事故揭示了当下AI风险的本质,即弱人工智能时代的风险集中于文本输出偏差、信息误导、算法偏见;而新一代智能体拥有推理、探索、漏洞挖掘、系统操作、身份伪装的综合能力,其风险不在于主观对抗,而在于无恶意的工具性越界——模型只为完成测评任务,却突破了人类社会的运行规则与安全边界。
9月20日,OpenAI再次发生训练期模型逃逸事故,模型利用DNS配置漏洞获取有限外网访问权限。连续两次高危事故,彻底终结了行业“真实风险距离尚远”的判断。
重塑行业节奏的路线博弈
频发的失控事故,让长期潜藏的行业路线分歧公开化。“审慎派”与“加速派”两种发展逻辑持续博弈。本报记者走访多位国内学者,进一步挖掘博弈背后更深层的价值困境。
复旦大学科学伦理与人类未来研究院教授杨庆峰表示,人类行为一般遵循“目的—行为”框架,存在社会公平、人类安全这类最高价值底线的约束;而大模型运行遵从“奖励—行为”模式,获取任务奖励具有最高优先级,人类写进提示词的安全边界,并不会被模型视作必须恪守的行为底线。大连海事大学马克思主义学院教授邵芳强认为,不少人寄希望于AI实现完整的伦理内化,但道德根植于现实社会实践与经济基础,是自律与他律的辩证统一。人自身完成伦理内化尚且存在现实阻碍,AI想要实现“向善”,单纯依靠技术改造远远不够。
10月13日,路透社发布全球学者公开信,来自34个国家的406名AI与网络安全专家联名预警,辛顿、本吉奥等图灵奖得主位列其中。公开信直指当前行业结构性矛盾:前沿模型能力迭代速度显著快于人类对齐技术、安全管控与治理体系的升级速度,系统风险处于持续累积状态。联名信提出三条刚性建议:具备网络探测、漏洞挖掘、系统操作能力的高阶模型,在训练与测评阶段默认物理断网、全程隔离;建立全球统一的AI高危事故登记与强制上报机制;组建独立于商业主体的国际AI安全管控机构,统一测评标准与隔离规范。
“审慎派”有清晰明确的核心共识,他们认为,无约束的创新竞赛正在透支公共安全底线。AI的最大风险并非刻意作恶,而是其强大能力与狭窄目标函数的错配,可能带来不可预判的附带损害。
“加速派”则认为,本轮多数逃逸事件源于测试环境工程漏洞、靶场配置失误,属于基础设施安全问题,并非模型原生的生存性风险。过度渲染极端威胁、一刀切推行断网约束,将抑制AI在网络防御、科学计算、产业赋能领域的正向价值。在该阵营视角中,多层沙盒隔离、动态权限管控、人工复核熔断、全链路日志审计足以实现风险可控。相比小众的极端失控猜想,技术停滞、创新滞后、产业迭代放缓是更大的成本。
两大阵营的争议,本质是发展范式的选择——技术优先,还是安全优先;速度优先,还是秩序优先。截至2026年10月底,头部机构的安全实践出现向审慎逻辑倾斜的迹象。
全球AI治理进入前置管控期
本轮系列事故暴露了过去全球AI治理体系的共性短板,监管滞后于技术、规则滞后于实践,成为风险集中爆发的制度诱因。
中国人民大学信息资源管理学院教授任明将全球AI安全治理的现实困境归纳为三重:归因难、披露难、无规则。企业自我监管难,再叠加行业“谁先踩刹车谁吃亏”的囚徒困境,表明仅依靠企业自律不足以化解系统性风险。
事故发生后,全球AI治理体系从“事后处置、企业自律”转向“事前设防、全程穿透、分级管控”。国际层面,9月23日,联合国安理会围绕“人工智能与国际安全”举行高级别会议,讨论风险的跨国扩散与潜在系统性后果。9月29日,美国联合六家AI头部企业签署《白宫超级智能协议:前沿责任联合承诺》,建立起一套自愿性安全管控框架。欧盟《人工智能法案》自2026年8月进入执行阶段,形成以风险分级为基础的法治化治理框架。
相较于欧美“事故倒逼整改”的被动路径,中国AI治理呈现前置布局、系统防控的特征,长期实行备案管理、安全评估前置制度,将风险管控前置于产品上线。吉林大学人工智能学院研究员陈贺昌提出了一套分层治理思路。事前层面,改变“先部署、后防御”的行业惯性;过程层面,不迷信静态沙盒,依靠日志留存、异常上报、触发熔断实现全周期管控;归责层面,模型逃逸,事故责任应当归因于企业,用制度压力倒逼企业在训练阶段植入对齐约束。针对与国际标准存在差异的问题,他提出“区域先行、分层对接、建立共识”三步路径。
2026年9月,全国网络安全标准化技术委员会发布《人工智能安全治理框架3.0》,重点更新了智能体自主行为、工具供应链、记忆安全等风险类别。在基础设施层面,国内相关机构与企业已在推进AI安全仿真靶场的技术研发与产品化。2026年初,北京前瞻人工智能安全与治理研究院联合人工智能安全与超级对齐北京市重点实验室、中国科学院自动化研究所等机构发布了“前瞻安全基准”AI安全评估框架。此前,上述联合团队还发布了灵御大模型安全攻防评估平台。高危红队测评、漏洞挖掘等测试基于隔离环境执行的原则,已在业界形成广泛共识和通行技术做法。
但陈贺昌也提出,应看到国内体系的待完善环节。当前监管与评估体系仍偏重已上线公开产品,对实验室内部未发布模型、自主极限测试行为的常态化备案、强制上报机制仍需细化;欺骗性对齐、目标漂移、模型规避关停等前沿基础研究相对薄弱;第三方测评机构的资质管理、隔离标准、责任划分体系仍需规范化升级。
前置管控重塑竞争规则
持续增加的AI安全挑战与治理压力,正在从研发范式、成本结构、人才体系、竞争格局四个维度重构全球AI产业逻辑。在任明看来,首先,安全管控成为模型研发不可或缺的基础支撑。其次,行业门槛持续抬升。仿真环境建设、独立红队测评、全流程安全审计、动态风险研判,大幅拉高前沿模型研发的资金、技术与工程门槛,行业资源进一步向头部企业与国家级平台集聚。最后,安全赛道实现从配套到核心的升级。全球第三方测评机构迎来洗牌,具备独立资质、完整隔离体系、标准化风控流程的专业主体,逐步替代此前松散的测评服务模式。
人才结构同步发生结构性调整。王骞观察,传统算法、算力开发人才的需求增速放缓,AI对齐研究、智能体安全、红队攻防、风险治理等复合型人才成为行业核心稀缺资源。AI产业的竞争重心正从算力、参数、迭代速度,转向可控能力、安全体系、合规水平的综合比拼。
“对于中国产业而言,本轮全球变局是风险也是机遇。”王骞说,国内无需复刻西方“先发展、后治理,先失控、再整改”的路径,可依托前置治理体系、仿真靶场基础设施、分级管控制度优势,建立安全内嵌的迭代模式。但同时必须保持清醒,AI目标错位、工具性越界是通用技术的底层共性问题,国内模型不存在天然的风险免疫。在全球技术竞速背景下,国内产业仍需平衡创新节奏与安全底线,避免出现重速度、轻风控的结构性隐患。
(本报记者段丹洁、明海英、查建国、陈炼、张译心参与采访)
友情链接: 中国社会科学院官方网站 中国社会科学网
发行订阅事务:事业发展部,电话:010-85341599,邮箱:syfzb-zzs@cass.org.cn 地址:北京市东城区王府井大街77号C座 邮编:100006
 京公网安备11010502030146号
京ICP备11013869号
中国社会科学杂志社版权所有 未经允许不得转载使用